深入解析大数据分析 Hadoop与大数据服务

在数字化时代,数据已成为企业的核心资产。如何从海量、多样、高速产生的数据中挖掘价值,是大数据分析要解决的核心问题。而Hadoop作为大数据技术的基石,以及围绕它构建的大数据服务生态,共同支撑起了现代大数据分析体系。本文将深入解析大数据分析、Hadoop以及大数据服务的概念、关系与应用。
一、什么是大数据分析?
大数据分析是指对规模巨大、类型多样、产生速度快的数据集进行采集、存储、处理、挖掘和可视化,以提取有价值的信息、发现规律、支持决策的过程。它通常涉及以下核心环节:
- 数据采集:从各类数据源(日志、数据库、传感器、社交媒体等)收集数据。
- 数据存储:使用分布式文件系统或NoSQL数据库存储海量数据,保证可靠性和可扩展性。
- 数据处理:通过批处理、流处理或交互式分析引擎对数据进行清洗、转换和计算。
- 数据分析与挖掘:运用统计分析、机器学习、数据挖掘算法发现模式和知识。
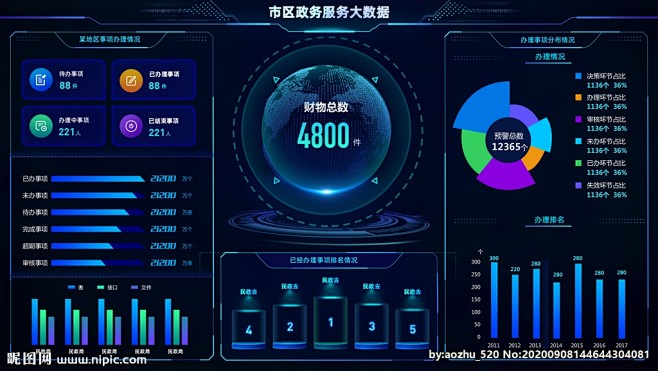
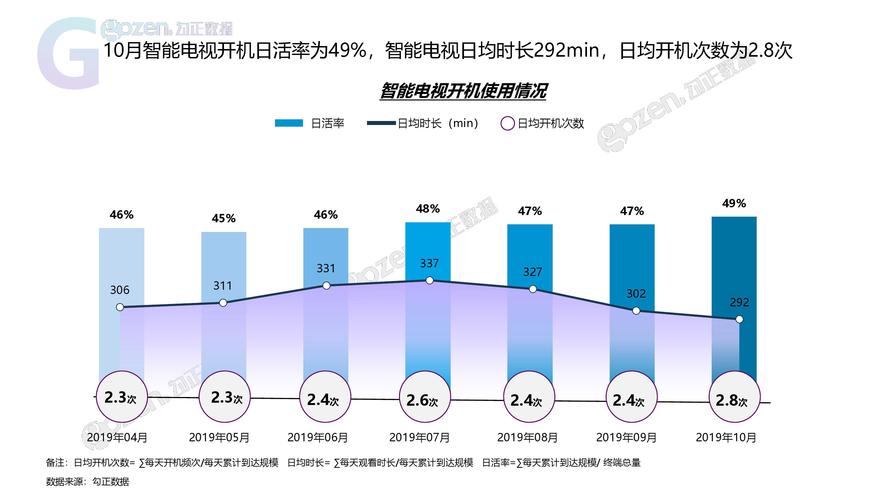
- 数据可视化:将分析结果以图表等形式呈现,辅助决策。
大数据的“4V”特征(Volume、Variety、Velocity、Value)决定了传统单机工具无法胜任,必须依赖分布式计算框架。
二、Hadoop:大数据分析的基石
Hadoop是一个开源的分布式计算平台,由Apache基金会维护,旨在用廉价硬件可靠地处理海量数据。它主要包括两大核心组件:
- HDFS(Hadoop Distributed File System):分布式文件系统,将文件切块存储在集群多台机器上,提供高容错和高吞吐量的数据访问。
- MapReduce:分布式计算模型,将计算任务分解为Map和Reduce阶段,自动并行化处理数据。
Hadoop生态还包括YARN(资源调度)、Hive(数据仓库)、HBase(NoSQL数据库)、Pig(数据流处理)、Spark(内存计算)、Flink(流处理)等众多项目,共同构成了完整的大数据处理栈。
Hadoop的核心价值在于:可扩展性(从单机扩展到数千节点)、成本效益(使用普通服务器)、容错性(数据多副本、任务自动重试)、灵活性(支持结构化、半结构化和非结构化数据)。
三、Hadoop与大数据分析的关系
Hadoop为大数据分析提供了底层存储和计算能力。分析人员可以通过Hive SQL、Spark SQL等工具在Hadoop集群上进行数据查询和挖掘;数据科学家可以利用Spark MLlib在Hadoop上运行机器学习算法。可以说,Hadoop降低了大规模数据分析的门槛,使PB级数据的处理成为可能。
四、什么是大数据服务?
大数据服务是指将大数据处理能力以服务化的方式提供给用户,通常包括云上大数据平台、托管Hadoop集群、数据仓库服务、实时计算服务、数据集成服务、机器学习平台等。其特点是免运维、弹性伸缩、按需付费、开箱即用。
主流云厂商(如AWS、阿里云、腾讯云、华为云)均提供丰富的大数据服务,例如:
- 托管Hadoop/Spark服务:如Amazon EMR、阿里云E-MapReduce,用户无需自行搭建和运维集群。
- 数据仓库服务:如Amazon Redshift、阿里云MaxCompute、华为云DWS。
- 实时计算服务:如阿里云Flink版、腾讯云Oceanus。
- 数据湖服务:如AWS Lake Formation、阿里云Data Lake Analytics。
- BI与可视化服务:如Quick BI、Tableau。
Hadoop与大数据服务的关系
Hadoop产品与大 Speaking 数据服
如若转载,请注明出处:http://www.ygii777.com/product/22.html
更新时间:2026-10-28 17:56:36